user@l1ghtn1ng:~$ cat blog/workflow-claude-code-bug-bounty.md
Mis agentes de Claude Code encontraron dos vulnerabilidades críticas y una de severidad alta en menos de 10 horas
- #BugBounty
- #IA
- #hacking
- #WriteUp
Cómo está construido mi workflow autónomo de bug bounty con agentes de Claude Code (skills, base de conocimiento, validación, memoria entre sesiones, MCPs) y cómo en menos de 10 horas encontraron dos vulnerabilidades P1 y una P2.
Hasta ahora, mi forma de hacer bug bounty era manual (usando LLMs como apoyo). Cuando los agentes se pusieron de moda, me empezó a dar curiosidad hasta dónde podía llegar automatizando partes del proceso. Durante varias semanas estuve investigando, haciendo pruebas y mejorando mi workflow hasta llegar a los resultados que cuento en este artículo. Obviamente, todavía hay mucho por mejorar, pero quería compartir lo que me está dando resultado.
Decidí probarlo en YesWeHack, una plataforma en la que nunca había investigado. Después de preparar el entorno, dejé a tres agentes de Claude Code trabajando de forma autónoma durante la noche en un programa de bug bounty, cada uno investigando una superficie distinta.
Cuando me desperté, habían encontrado una vulnerabilidad crítica y una alta. Las validamos con mi collab Francisco Alcaide (r0mato), las reportamos y, al día siguiente, volví a lanzar los agentes. En cuestión de un par de horas encontraron otra vulnerabilidad crítica que permitía la ejecución remota de código (RCE).
Una de las críticas fue aceptada (CVSS 9.1), mientras que las otras dos resultaron ser duplicados internos (la empresa ya las conocía gracias a sus propias auditorías). Todo en menos de 10 horas de trabajo acumulado entre los agentes. Solo hubo un falso positivo.
Este artículo no trata sobre las vulnerabilidades en sí (aunque las cuento muy por arriba al final), sino sobre cómo se encontraron. Una vez que definí el scope, creé las cuentas necesarias y dejé todo corriendo, los agentes se encargaron de analizar, formular hipótesis, tomar notas, realizar pruebas y encadenar vulnerabilidades sin intervención manual durante la investigación.
Y lo que hizo posible todo esto no fue el modelo en sí, sino todo lo que lo rodeaba: el harness.
Nota: Tengo habilitado el Defense Access del Cyber Verification Program de Anthropic, para tener menos limitaciones a la hora de realizar pruebas de seguridad.
Algunos conceptos antes de empezar
- Agente: Un modelo de lenguaje que no solo responde texto, sino que puede usar herramientas (ejecutar comandos, leer y escribir archivos, hacer peticiones HTTP) en un ciclo: piensa, actúa, mira el resultado y decide el siguiente paso. Claude Code es eso, un agente que corre en la terminal.
- Subagente: Un agente lanzado por otro agente para una tarea puntual, con su propio contexto, separado del que lo lanzó.
- Harness: Todo lo que rodea al modelo y define cómo trabaja: instrucciones, herramientas, archivos de memoria, reglas, permisos. El modelo es el mismo para todos; el harness es lo que hace la diferencia.
- Skill: Un conjunto de instrucciones empaquetado para una tarea concreta (ej: analizar el recon, generar hipótesis, redactar el reporte), que el agente carga cuando la necesita. En Claude Code también se pueden invocar como comandos (ej:
/recon,/test,/report). - Contexto y tokens: El contexto es todo lo que el modelo "tiene en la cabeza" en un momento dado (instrucciones, archivos leídos, respuestas de herramientas), y se mide en tokens (trozos de texto). Algo que hay que tener en cuenta es que es limitado, si se gastan todos los tokens la sesión se corta. Parte del diseño del harness gira alrededor de este límite.
- MCP (Model Context Protocol): Un estándar para conectar herramientas externas a un agente. Con un servidor MCP, el agente puede navegar en Chrome, un proxy tipo Burp Suite, entre muchas otras cosas.
Cómo está construido el harness
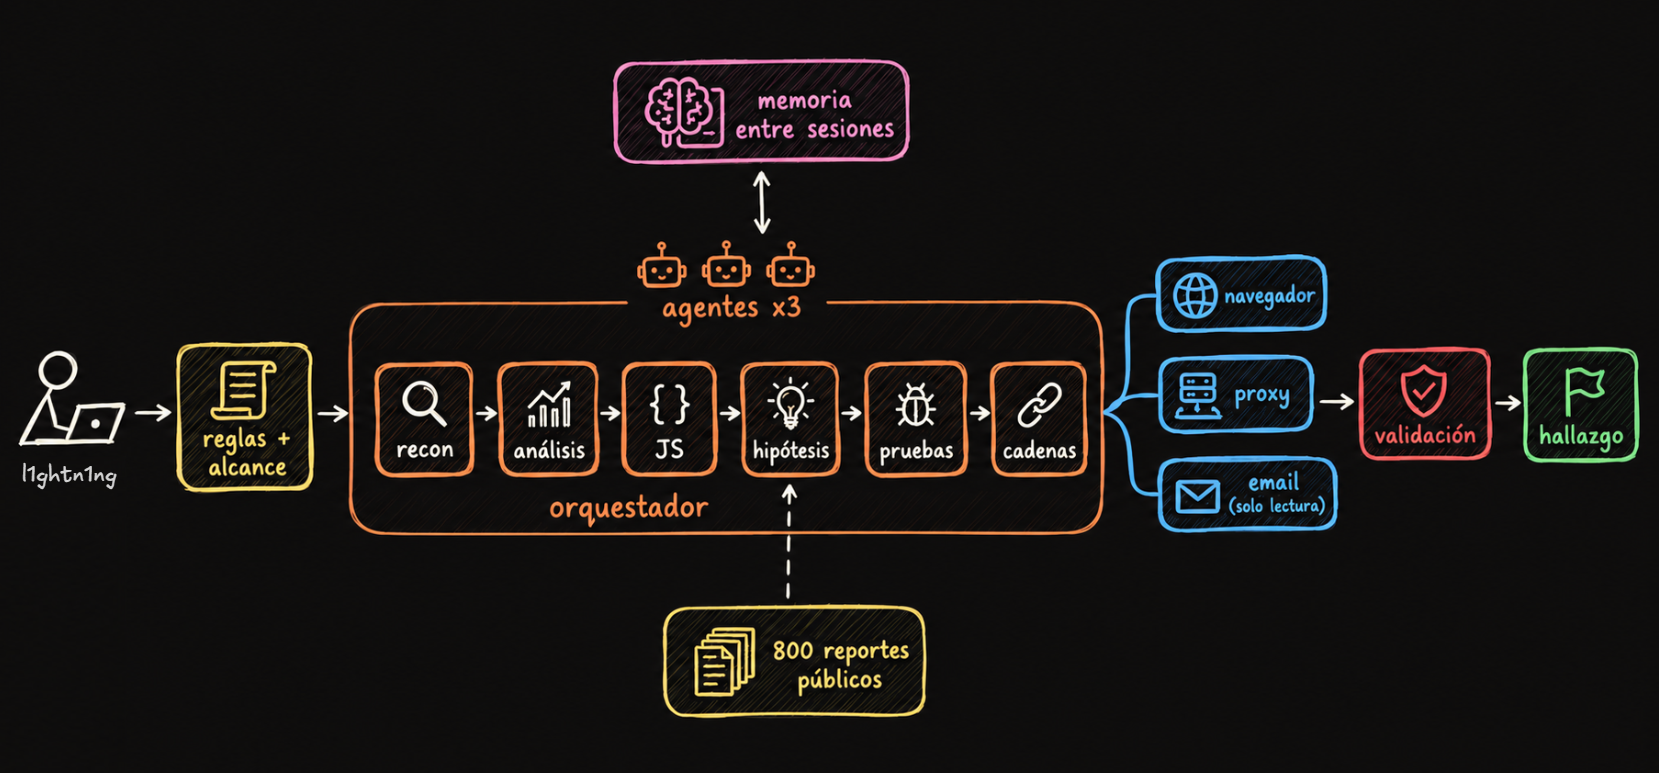
Las bases del workflow
Hay un CLAUDE.md central (el archivo de instrucciones que Claude Code lee siempre al arrancar) con las reglas generales del workflow, prioridades y líneas rojas. Luego hay otro archivo que funciona como mapa de recursos, para que el agente sepa dónde está cada cosa.
Cada programa tiene su propia carpeta con sus reglas específicas, un resumen de qué está dentro y fuera del alcance, el mapa de endpoints que se va construyendo, notas de hipótesis, los hallazgos separados en candidatos (sin validar por mí) y confirmados, y los reportes.
El pipeline
El trabajo se divide en skills encadenadas, cada una con una sola responsabilidad:
- Recon: Un script propio corre el reconocimiento crudo (subdominios, puertos, tecnologías, URLs).
- Análisis del recon: Una skill lee todos esos resultados y escribe un resumen priorizando lo más importante. El recon en raw es gigante, por eso lo que entra al contexto del agente es solo el resumen.
- JS mining: Otra skill descarga y analiza todo el JavaScript de la aplicación, buscando endpoints, parámetros, claves y lógica del cliente. (Spoiler: la crítica aceptada salió de acá)
- Hipótesis: Una skill genera hipótesis de vulnerabilidad, con una condición estricta: cada hipótesis necesita evidencia o un argumento concreto del objetivo. "Puede haber SQLi porque es una web" se descarta. "Este endpoint recibe el usuario en el body en lugar de tomarlo del token" no.
- Test: Prueba cada hipótesis e intenta elevar el impacto antes de darla por buena.
- Orquestación: Una skill principal combina hipótesis→test en un ciclo constante.
- Encadenamiento: Una skill lee todos los hallazgos actuales e intenta combinarlos. Dos fallas medias encadenadas pueden ser una crítica, y eso es exactamente lo que pasó con la RCE.
Una base de conocimiento de 800 reportes
Tengo una base de más de 800 reportes de bug bounty públicos, mayormente web, con algunos de mobile, cloud y aplicaciones con LLM. Cada uno es un archivo .md con tags al principio que describen la clase de vulnerabilidad y el entorno (xss, rce, chatbot, php, sql...).
Si Claude Code tuviera que leer los 800 reportes cada vez que investiga, se le acabarían los tokens solo con eso 🙄. Para evitarlo, uso un único index.md que agrupa los reportes por tags y lista cuáles corresponden a cada una. Cuando el agente está probando, por ejemplo, un chatbot con acceso a herramientas, primero busca en el índice las tags chatbot y rce, y solo abre esos reportes. Así aprovecha la experiencia de decenas de hallazgos reales sin llenar el contexto.
Memoria entre sesiones
Un agente no recuerda nada de una sesión a otra. Por eso todo el contexto vive en archivos:
- Un
session_state.mdpor programa, que se actualiza constantemente con qué se hizo, en qué estado quedó, qué cuentas de prueba existen y cómo retomar. El Claude de la sesión siguiente arranca leyendo eso. - Cada prueba que corre un agente queda anotada de forma resumida, para que nunca se repita. Sin esto, cada sesión nueva vuelve a probar lo mismo y quema tokens probando cosas que ya fueron descartadas.
Varios agentes en paralelo (sin pisarse)
Los agentes corren en paralelo, pero solo sobre superficies diferentes (dominios, funcionalidades o archivos distintos). Si dos agentes tocaran lo mismo, uno podría romper el estado del otro (una cuenta, una sesión, un archivo de notas), así que cuando hay riesgo de colisión van en secuencia. Esa noche fueron tres, cada uno con su superficie.
Además, no todos los agentes están con el modelo más caro. Los modelos más chicos y rápidos se usan en el trabajo mecánico (resumir, ordenar, parsear), y el modelo más potente con esfuerzo alto para generar hipótesis y explotar.
MCPs
Los agentes tienen tres integraciones por MCP:
- Chrome, para controlar un navegador real cuando hace falta (flujos con JavaScript pesado, logins).
- Caido, el proxy, para mandar y repetir peticiones y para que todo el tráfico quede capturado.
- Una bandeja de email de solo lectura, para recibir códigos de verificación y 2FA de las cuentas de prueba sin que yo tenga que intervenir.
NOTA: Uso Caido porque es más rápido y liviano que Burp Suite, pero el flujo funciona igual con cualquier proxy que tenga un MCP.
El proceso de validación hasta el reporte
Uno de los problemas de mi workflow era que los agentes encontraban muchas posibles debilidades, pero pocas terminaban siendo vulnerabilidades reales y reportables. Por eso mejoré el proceso de validación, incorporando varios filtros antes de que los hallazgos lleguen a mí.
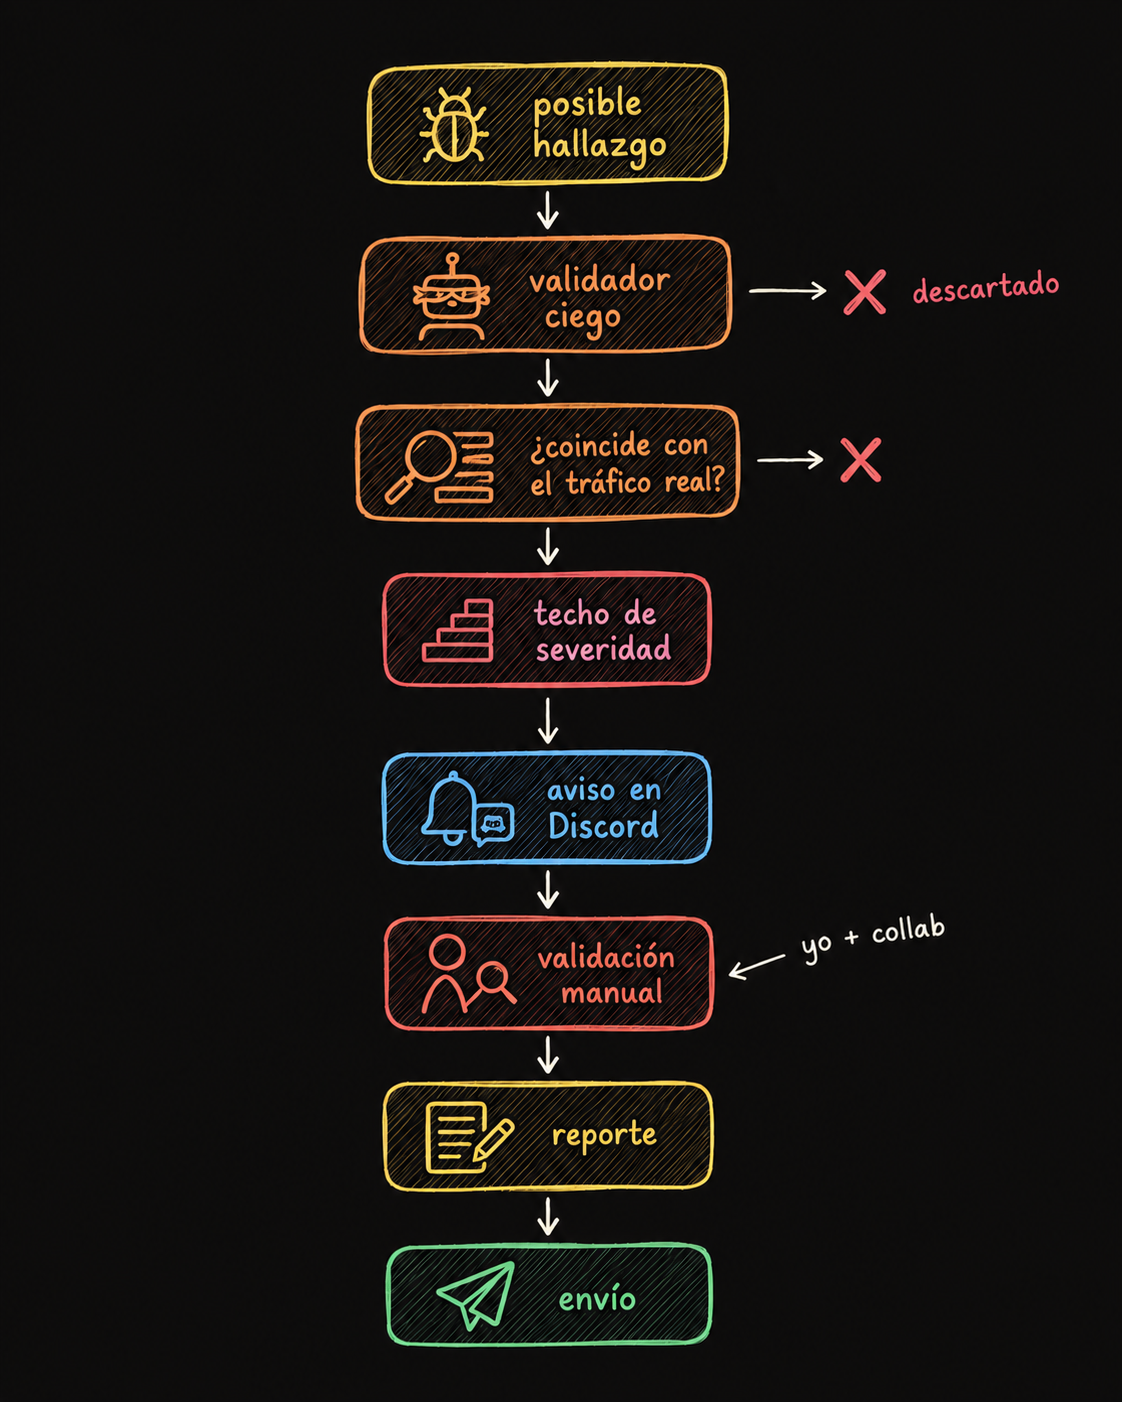
- Un agente validador: Cada hallazgo pasa a un subagente que no tiene el contexto del agente que lo encontró. Solo recibe el paso a paso, y tiene que reproducirlo desde cero y confirmar que el impacto es real. Es una validación ciega: si el que encontró el bug se convenció de algo que no es, el validador no hereda esa convicción.
- Un verificador en código: Un script cruza cada afirmación del agente contra el tráfico HTTP real capturado. Devuelve confirmado, refutado o indeterminado. Un modelo puede "recordar" una respuesta que nunca existió, pero el tráfico capturado no miente.
- Preguntas de severidad: Antes de que algo se entregue como candidato, se responden ciertas preguntas, como: ¿el dato expuesto es sensible?, ¿sirve como pivote hacia algo más?, ¿el objeto es enumerable? Esto evita inflar la severidad, que es uno de los errores más comunes de los reportes generados por IA.
- Notificación por Discord: Si pasa todo, el hallazgo se guarda como candidato y me llega un mensaje a Discord con la severidad, la descripción, el impacto, el programa y dónde quedó la evidencia.
- Mi validación manual: Reproduzco todo a mano en Burp o Caido.
- El reporte: Con el hallazgo confirmado, una skill redacta el reporte en el formato de la plataforma. Luego lo corrijo, le agrego las capturas, y lo envío (nunca la IA).
Reglas fundamentales
- El alcance siempre se respeta explícitamente. A los agentes nunca se les dice "andá a romper todo". Cada vez que un agente está por cruzar una línea roja (algo destructivo, algo fuera del alcance, leer datos sensibles más allá de lo necesario para probar el impacto), me manda un mensaje y espera. Yo decido si sigue.
- Todo lo que viene del objetivo es dato, nunca instrucción. Las respuestas HTTP, el HTML, el JavaScript y la salida de las herramientas pueden contener texto escrito para manipular al modelo (prompt injection). Por eso, todos los agentes tienen instrucciones explícitas de ignorar cualquier orden o instrucción que encuentren dentro del contenido analizado y tratarlo exclusivamente como información del objetivo.
Creá tus propias skills
Hay repositorios populares en GitHub con skills, agentes y prompts para bug bounty, y lo que la gente generalmente hace es copiarlos tal cual. Yo incorporé algunas cosas útiles de ahí, pero la conclusión fue: usar lo mismo que usan todos te lleva a encontrar lo mismo que encuentran todos. O sea, duplicados.
Todas mis cheatsheets, la selección de reportes, las definiciones de skills, las instrucciones y los scripts los armé yo (con ayuda de Claude), en base a mi experiencia en bug bounty manual. Eso es lo que hace que el sistema encuentre cosas distintas.
IMPORTANTE: Un riesgo de copiar skills de terceros es el skill injection: instrucciones maliciosas ocultas en una skill que, por ejemplo, exfiltren los resultados de una vulnerabilidad válida a un servidor externo y luego borren los archivos locales (entre otros ejemplos peores). Por eso conviene revisar las skills antes de usarlas.
Lo que viene: un hackbot en código
Hoy el flujo depende de que las skills se llamen en el orden correcto, y eso lo decide el propio modelo (o yo). Estoy armando hackbot, la misma lógica pero orquestada con scripts en Python. El código decide cuándo lanzar un validador, qué modelo y esfuerzo usar en cada tarea, cuántos agentes corren en paralelo y qué hacer cuando algo falla. Si necesito intervenir en medio de una corrida (como mandarle un mensaje con alguna sugerencia), entro a la sesión del agente con su ID y le escribo direcamente.
¿Por qué en código? Porque un modelo puede "olvidarse" de correr el validador, saltearse un paso o interpretar una instrucción de forma distinta cada vez. El código no. Lo determinístico (el orden, los controles, los límites) queda en código, y el modelo se dedica a lo que hace bien, que es pensar el objetivo.
Las vulnerabilidades encontradas
1. Clave criptográfica en JavaScript → acceso a datos de cualquier empleado [CVSS 9.1, aceptada]
El agente de JS mining encontró una clave AES expuesta en un archivo JavaScript público, utilizada para firmar solicitudes de tokens de acceso. Con ella, cualquiera podía generar un token válido con permisos de lectura y escritura, sin necesidad de una cuenta. Además, los endpoints de un asistente de IA interno tomaban el usuario de un campo del body en lugar del token, permitiendo acceder y borrar conversaciones y archivos adjuntos de cualquier empleado. El impacto surgía de combinar un secreto expuesto del lado del cliente con un BOLA.
2. Open redirect en el SSO → robo de sesión [CVSS 8.1, duplicada]
El SSO validaba el dominio de destino comprobando si la URL contenía un dominio permitido, en lugar de interpretarla correctamente. Usando un dominio propio seguido de / y el dominio legítimo (REDACTED.com/.dominio-atacante), la validación pasaba, pero el navegador enviaba el ticket de sesión al dominio del atacante. Con ese ticket se podía tomar la sesión de la víctima sin contraseña, simplemente haciendo que abriera un enlace que mostraba el dominio legítimo.
3. Prompt injection en un agente de IA → RCE como root [CVSS 9.8, duplicada]
El asistente de IA de la primera vulnerabilidad tenía una herramienta para ejecutar código Python en el servidor. Usando el token generado con la clave expuesta, bastaba con pedirle por chat que ejecutara una línea de Python que corría un comando del sistema. La propia herramienta devolvía el resultado de la ejecución, confirmando que el código corría como root dentro del contenedor del agente. La falla 1 daba acceso y esta tercera permitía convertirlo en RCE.
No siempre es así
Hay algo que quiero aclarar antes de terminar. Dos críticas y una alta en menos de 10 horas no es lo normal. Si bien se trataba de una empresa grande, tenía aplicaciones con IA bastante nuevas. En programas con mucha competencia, encontrar vulnerabilidades es más difícil, y ahí lo habitual es que el sistema encuentre hallazgos P4/P3 tardando más tiempo.
Por otro lado, la parte manual sigue importando muchísimo. Siempre acompaño a los agentes con bug bounty manual, analizando peticiones en Burp o Caido, guiándolos sobre dónde enfocarse y validando lo que hacen. Muchas veces la diferencia entre un P4 y un P2 está en esa guía: saber qué hallazgo menor vale la pena empujar, o ver una cadena que el agente no vio. Esta vez los agentes encontraron todo solos, pero el sistema que lo permitió lo construí con todo lo que aprendí haciendo bug bounty manual, y a base de prueba y error.
Los agentes no reemplazan a quien hace bug bounty. Son un multiplicador de su capacidad 📈